Audio hochladen

Lege deine Audiodatei hier ab

MP3, WAV, FLAC, M4A – bis zu 10 MB

KI Voice Changer

Du verwendest ein privates Stimmmodell, das aus deiner eigenen oder ausdrücklich autorisierten Stimme trainiert wurde.

Hier ist noch nichts

Erzeuge links einen Track. Das Ergebnis erscheint hier.

Ablauf des KI Voice Changers

Stimme in 3 Schritten verändern

Ändere den Sänger in einem Song oder einer Gesangsaufnahme in drei Schritten. Verwende Audio- und Sprachmodelle, die du besitzt oder die du umwandeln darfst.

1

Lade einen Song oder Gesang hoch

Lade eine MP3-, WAV-, FLAC- oder M4A-Datei mit bis zu 10 MB hoch oder wähle einen geeigneten Song aus „Meine Mediathek“ aus. Ein sauberer, isolierter Gesang erzeugt normalerweise die deutlichste Veränderung der Singstimme.

2

Wähle ein Sprachmodell

Wähle eine verfügbare voreingestellte Stimme oder ein privates Modell, das aus deiner eigenen oder ausdrücklich autorisierten Stimme trainiert wurde.

3

Generieren, Vorschau und Export

Überprüfe den Credit-Bedarf auf der Schaltfläche „Stimme ändern“, erstelle das Ergebnis und höre es dir an, bevor du es herunterlädst. Wähle MP3- oder WAV-Ausgabe; für MP3-Downloads ist ein Abonnement erforderlich und die zulässige Nutzung hängt von deinem Plan und den Quellrechten ab.

KI-Stimmen für Songs, Videos und Livestreams

Verwende hochgeladene Audiodaten, um Gesangsstimmen zu testen, Songcover vorzubereiten, Charakterstimmen zu prototypisieren und transformierte Clips für Inhalte zu erstellen.

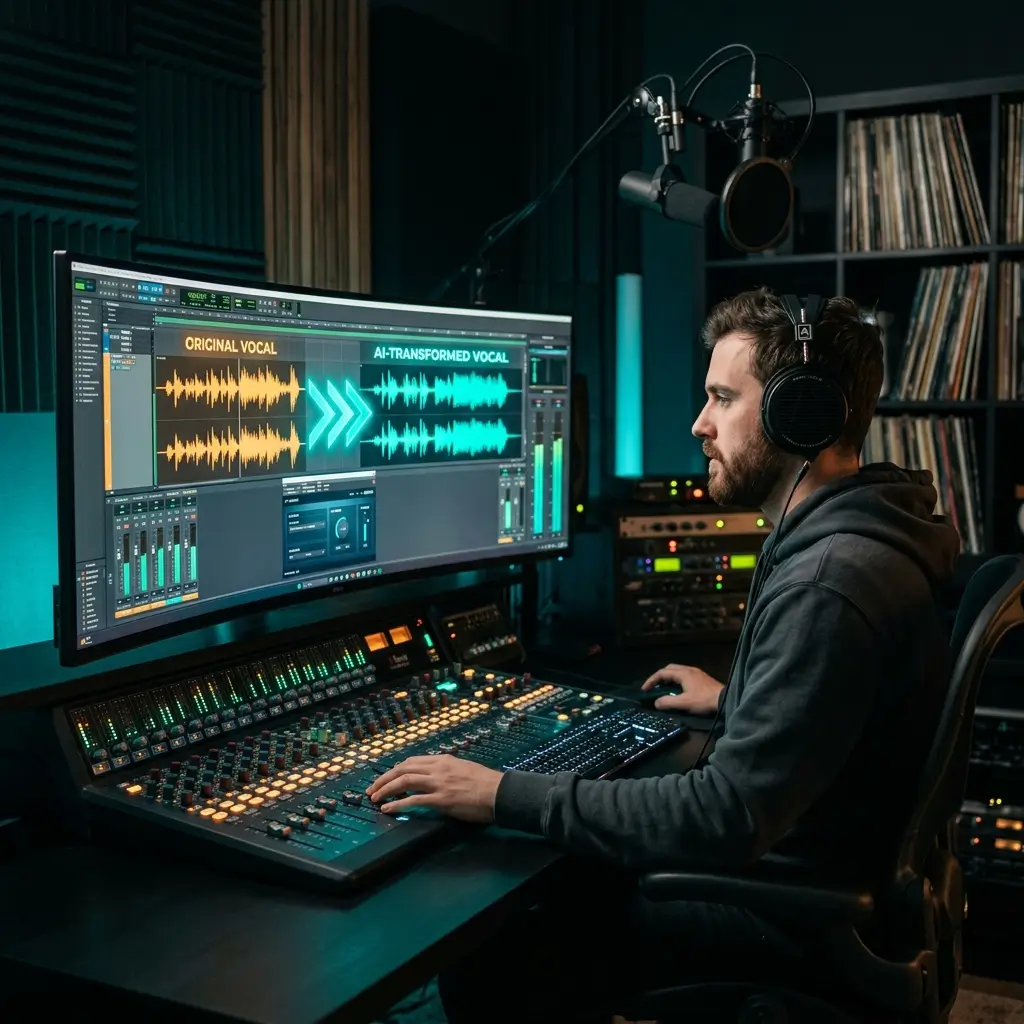
Musikproduzent transformiert einen Gesangstrack mit KI-Voice-Changer für einen KI-Coversong

AI-Cover-Songs und Musik-Remixe

Tausche das Timbre der Stimme eines Sängers aus und behalte dabei Tonhöhe, Vibrato und Emotionen bei. Produzenten nutzen dies für KI-Cover, Mashups und Remix-Experimente – eine Neuaufnahme ist nicht erforderlich. Kombiniere es mit unserem AI Vocal Remover für isolierte Tracks.

YouTube-Ersteller nutzt den KI-Sprachwechsler, um Charakterstimmen zu einem Video hinzuzufügen

YouTube-Videos und Content-Erstellung

Erstelle eindeutige Erzähler- oder Charakterstimmen, ohne Synchronsprecher engagieren zu müssen. Der KI-Sprachmodifikator liefert Ergebnisse in Studioqualität, die natürlich klingen – nicht wie ein billiger Filter. Hebe dich mit Original-Audio ab, das kein anderer Creator hat.

Podcaster, der mit dem KI-Sprachwechsler mehrere Charakterstimmen erstellt

Podcasts und professionelle Voiceovers

Spiele mehrere Charaktere in einer Storytelling-Episode aus einer einzigen Aufnahme. Der Stimmtransformator bewahrt den natürlichen Sprechrhythmus und verändert gleichzeitig die Stimmidentität. Synchronsprecher nutzen es, um ihr Angebot für mehr Vorsprechen zu erweitern.

Gamer und Streamer, der den KI-Sprachwechsler während eines Live-Twitch-Streams verwendet

Gaming, Streaming und Discord

Transformiere vorab aufgezeichnete Clips für Discord, Twitch und Gaming-Inhalte. Das ist ein auf Uploads basierender Sprachwechsler und kein Echtzeit-Mikrofonfilter. Erstelle also Clips, bevor du sie einer Live-Produktion hinzufügst.

Social-Media-Ersteller, der ein TikTok-Video mit KI-Spracheffekten erstellt

TikTok- und Social-Media-Inhalte

Original-Audio erhält auf jeder Plattform mehr Reichweite. Verwende den KI-Stimmenwechsler, um einzigartige Stimmeffekte für Reels, Shorts und TikToks zu erstellen, die in der ersten Sekunde Aufmerksamkeit erregen. Kein anderer Creator wird deinen genauen Sound haben.

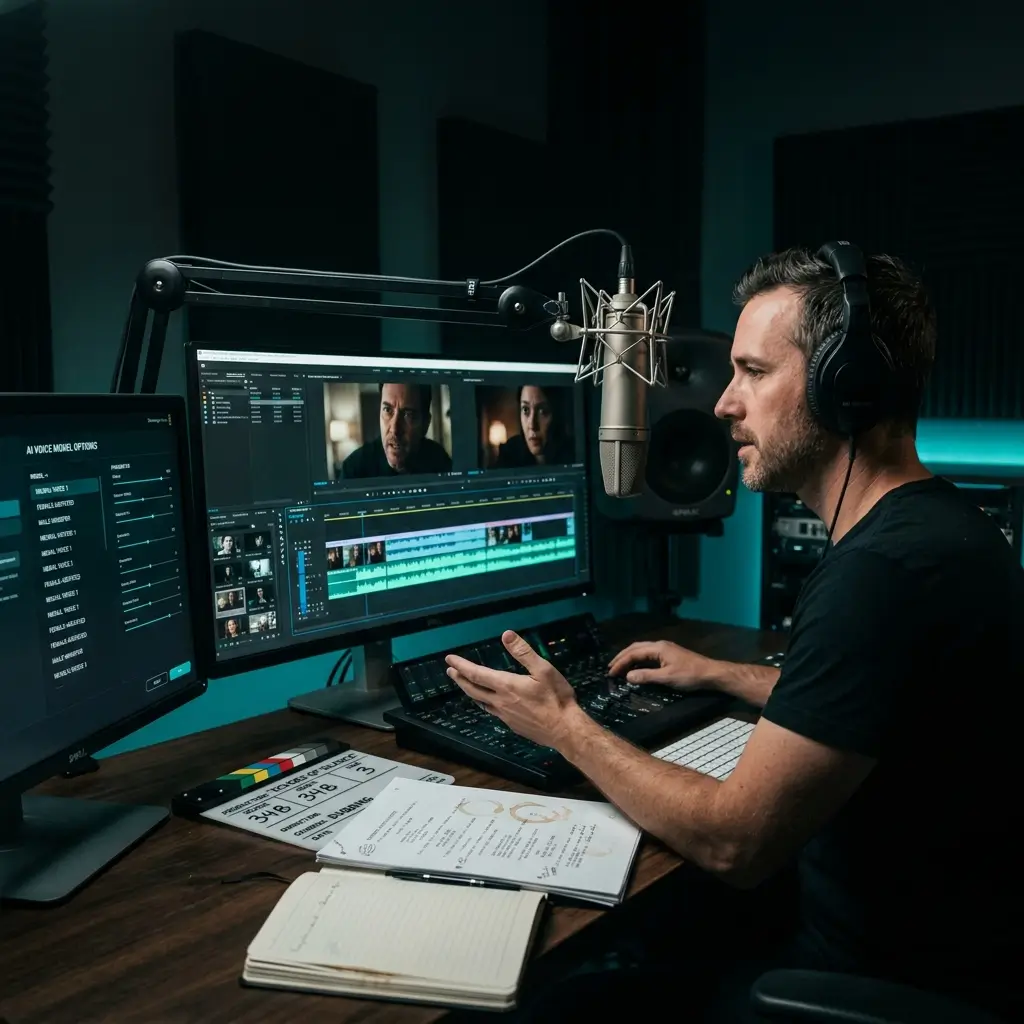
Filmemacher nutzt KI-Sprachwechsler für die Synchronisation von Dialogen in der Postproduktion

Filmsynchronisation und Synchronsprecher

Prototyp-Charakterstimmen während der Vorproduktion, ohne die Schauspieler neu zu besetzen. Der KI-Sprachkonverter bewahrt das lippensynchrone Timing und die emotionale Übermittlung und transformiert gleichzeitig die Stimmidentität vollständig. Synchronsprecher nutzen es, um Demo-Reels zu erweitern.

So passt du Stimme, Modell und Tonhöhe an

Der Workflow ist für hochgeladene Songs und Gesang konzipiert, mit Auswahl des Stimmmodells, Tonhöhenoptionen, benutzerdefiniertem Stimmtraining und Audioexport in einem Browser-Tool.

Ein klarer Ablauf vom Upload bis zum Export

3 Schritte

Lade eine Quelle hoch oder wähle sie aus, wähle die Zielstimme und die Tonhöheneinstellung und erstelle dann das Ergebnis und schaue es dir in der Vorschau an. Die Verarbeitungszeit variiert je nach Quelldatei und aktueller Dienstauslastung.

Gebaut für die Konvertierung von Gesangsstimmen

Ändere die Klangfarbe deiner Stimme und behalte dabei die Leistung, Melodie, das Timing und den Ausdruck der Quelle so genau bei, wie es das ausgewählte Modell zulässt. Saubere, isolierte Vocals liefern im Allgemeinen das beste Ergebnis.

Offizielle und benutzerdefinierte Sprachmodelle

Trainiere ein privates Stimmmodell aus 1–10 Stimmproben, die dir gehören oder für die du eine ausdrückliche Erlaubnis hast.

100 % browserbasiert – keine Installation

Keine Desktop-App frisst deinen Arbeitsspeicher. Öffne die Seite auf Mac, Windows, Chromebook oder Mobilgerät und beginne sofort mit der Konvertierung. Nichts zum Herunterladen oder Aktualisieren.

MP3- und WAV-Ausgabe

Wähle vor dem Generieren das Ausgabeformat, schau dir die transformierte Stimme im Browser an und lade das Ergebnis herunter, wenn es fertig ist. Der MP3-Download-Zugang hängt von deinem Plan ab.

Stimm-Workflows mit geklärten Rechten

Verwende deine eigenen Aufnahmen oder Material, das du umwandeln darfst. Beim individuellen Stimmtraining sollten nur Beispiele von einer Person verwendet werden, die die erforderliche Erlaubnis erteilt hat.

Erfahrungen mit dem KI Voice Changer

Creator verändern Gesang für Songs, Videos und andere Projekte. Das sagen sie über ihre Ergebnisse.

Ich mache KI-Cover aus Spaß und Profit. Dieser Stimmverzerrer ist der einzige, der die Emotion des Originalgesangs beibehält und gleichzeitig die Stimme komplett austauscht. Andere Tools, die ich ausprobiert habe, klangen flach und roboterhaft. Das klingt echt.
Jordan Lee

Jordan Lee

Musikproduzent und Beatmaker

Ich spreche jeden Charakter in meiner Zeichentrickserie selbst aus. Mit diesem KI-Stimmenwechsler kann ich 6 verschiedene Charaktere aus meiner eigenen Stimme erstellen. Mein Publikum hat keine Ahnung, dass ich es bin. Ich habe Tausende an Synchronsprechern gespart.
Mia Torres

Mia Torres

YouTube-Creator, über 350.000 Abonnenten

Die Stimmen der Charaktere verleihen meinen Erzählabschnitten so viel Persönlichkeit. Zuhörer fragen immer, wie ich sie erstelle. Die Qualität ist sendebereit – keine Nachbearbeitung erforderlich. Dieses Tool ist meine Geheimwaffe.
David Kim

David Kim

Podcast-Moderator, Tech Unplugged

Mein Chat geht total durcheinander, wenn ich mitten im Stream die Stimme wechsle. Die Konvertierung ist so schnell und natürlich, dass die Leute wirklich nicht erkennen können, dass es sich um KI handelt. Es ist zum am häufigsten nachgefragten Teil meiner Inhalte geworden.
Luna Zhang

Luna Zhang

Twitch-Streamer, über 80.000 Follower

Original-Audio ist bei TikTok alles. Ich verwende das, um Spracheffekte zu erzeugen, die sonst niemand hat. Meine Videos mit KI-Spracheffekten werden dreimal häufiger geteilt als meine regulären Inhalte. Die Klangqualität ist viel besser als bei jeder App, die ich ausprobiert habe.
Marcus Rivera

Marcus Rivera

TikTok-Ersteller, 1,2 Millionen Follower

Ich benutze das, um meinen Stimmumfang für Vorsprechen zu erweitern. Ich kann eine tiefe männliche Erzählerstimme oder eine strahlende junge Charakterstimme vorführen – alles aus meinen eigenen Aufnahmen. Es hat Projekttypen eröffnet, die ich vorher nie hätte landen können.
Sophie Adams

Sophie Adams

Synchronsprecher und Erzähler

Fragen und Antworten zu KI Voice Changer

Antworten zu Gesangsstimmenänderungen, Quelldateien, Stimmmodellen, Credits, Downloads, individuellem Training, Datenschutz und kommerzieller Nutzung.

Der KI Voice Changer erfordert ein aktives Pro- oder Studio-Abo. Jede Stimmänderung verbraucht die auf der Schaltfläche angezeigte Anzahl an Credits; für eine kommerzielle Nutzung brauchst du außerdem alle erforderlichen Rechte an Quelle und Stimme.

Das System analysiert die Quellleistung und wendet das ausgewählte Ziel-Sprachmodell an. Im Gegensatz zur einfachen Tonhöhenverschiebung ändert es die Klangfarbe der Stimme und zielt darauf ab, den Text, die Melodie, das Timing und den Ausdruck des hochgeladenen Lieds oder Gesangs beizubehalten.

Der Musik-Voice-Changer ist so konzipiert, dass er die Melodie, das Timing, das Vibrato und den Ausdruck der Quelle beibehält und gleichzeitig die Klangfarbe der Stimme ändert. Die Ergebnisse hängen immer noch von der Qualität der Quelle und dem ausgewählten Modell ab. Verwende also einen sauberen, isolierten Gesang und sieh dir die Ausgabe vor dem Herunterladen an.

Lade MP3-, WAV-, FLAC- oder M4A-Dateien mit bis zu 10 MB hoch oder wähle einen geeigneten Song aus „Meine Mediathek“ aus. Die direkte Mikrofonaufnahme ist beim Sammeln von Samples für ein benutzerdefiniertes Sprachmodell verfügbar, nicht als Hauptquelle-Audioeingang.

Die Bearbeitungszeit variiert je nach Quellenlänge, ausgewähltem Modell und aktueller Serviceauslastung. Fortschritt erscheint im Arbeitsbereich, während der Song-Voice-Changer läuft; das individuelle Training des Stimmmodells ist ein separater Prozess und dauert normalerweise 5–15 Minuten.

Die Modellauswahl enthält eine begrenzte Zahl voreingestellter Stimmen und deine privaten Modelle. Neue eigene Modelle werden nach Bestätigung der Sprechererlaubnis aus 1–10 sauberen Aufnahmen trainiert.

Für das sauberste Ergebnis verwende einen isolierten Gesang. Wenn die Quelle Instrumente enthält, verwende zuerst den AI Vocal Remover und transformiere dann den abgetrennten Gesang. Wenn du einen Workflow möchtest, der den Sänger oder Musikstil rund um einen ganzen Song ändert, verwende den AI Cover Generator.

Während Pro oder Studio aktiv ist, kannst du in deinem Konto eine kommerzielle Nutzungslizenz für berechtigte transformierte Audiodaten erwerben, einschließlich der vor dem Upgrade erstellten Ausgabe. Ausgaben aus Free und Creator bleibt für den persönlichen, nicht kommerziellen Gebrauch, sofern nicht später eine Lizenz erteilt wird. Du musst auch die notwendigen Rechte und Einwilligungen für die Audioquelle und Stimme haben.

Deine Datei wird für den von dir gestarteten Vorgang verarbeitet. Details zu Speicherung, Löschung und weiteren Verwendungszwecken findest du in der aktuellen Datenschutzerklärung. Lade nur Material hoch, das du verarbeiten darfst.

Die Stimmänderung wendet ein Zielmodell auf einen vorhandenen Song oder eine Gesangsdarbietung an. AI Voice Cloning erstellt ein wiederverwendbares benutzerdefiniertes Modell aus Sprachbeispielen. BeMusic unterstützt beides durch separate Arbeitsabläufe, und benutzerdefinierte Modelle sollten nur mit Erlaubnis des Sprechers trainiert und verwendet werden.

Du kannst vorab aufgezeichnete Clips umwandeln und die erlaubte Ausgabe in Discord, Spielen oder Streams verwenden. Diese Seite ist kein Echtzeit-Mikrofon-Sprachwechsler; es verarbeitet eine hochgeladene Datei oder einen aus deiner Bibliothek ausgewählten Song.

BeMusic ist ein Upload-basierter Musik-Stimmenwechsler für Songs und Gesang, kein Echtzeit-Mikrofonfilter. Er kombiniert Quellen-Upload, private autorisierte Stimmmodelle, Tonhöhenoptionen und MP3- oder WAV-Ausgabe im Browser.

Du kannst in der Tonhöheneinstellung vor der Generierung „Männlich zu weiblich“, „Weiblich zu männlich“ oder „Keine Änderung“ auswählen. Das ausgewählte Stimmmodell hat immer noch den größten Einfluss auf den endgültigen Stimmcharakter, also sieh dir das Ergebnis in der Vorschau an und passe die Einstellung bei Bedarf an.

Nein. Alles läuft in deinem Webbrowser. Nichts zum Herunterladen, Installieren oder Aktualisieren. Funktioniert auf Mac, Windows, Linux, Chromebook, iPad oder Telefon. Öffne die Seite und beginne mit der Konvertierung.

Die Regeln variieren je nach Gerichtsbarkeit und Anwendungsfall. Verwandle Audio und Stimmen nur, wenn du über die erforderlichen Rechte und Einwilligungen verfügst, und verwende die Sprachkonvertierung niemals für Betrug, Täuschung, Belästigung oder unbefugten Identitätswechsel. Überprüfe die Regeln, die für dein Projekt gelten, bevor du es veröffentlichst.

Du kannst das Stimmmodell auswählen, für die Tonhöhe „Keine Änderung“, „Männlich zu weiblich“ oder „Weiblich zu männlich“ auswählen und zwischen MP3- und WAV-Ausgabe wählen. Das aktuelle Tool stellt keine separaten Intensitäts- oder Konvertierungsstärke-Schieberegler zur Verfügung.

Ja. Lade 1–10 saubere Stimmproben (jeweils 10 Sekunden bis 5 Minuten) hoch und das System trainiert in 5–15 Minuten ein benutzerdefiniertes Stimmmodell. Wenn du fertig bist, verwende es wie jedes andere Modell im Sprachwechsler. Damit kannst du eine einzigartige Stimmidentität erstellen, auf die sonst niemand Zugriff hat.

Hast du noch weitere Fragen? Kontaktiere unser Team – wir helfen dir gerne weiter.

Jetzt ausprobieren: KI Voice Changer

Wähle Pro oder Studio, lade einen Song oder eine einzelne Stimme hoch und wähle ein erlaubtes Stimmmodell. Eine Softwareinstallation ist nicht erforderlich.